

AI 字幕
Beam 会从启用的音频片段在本地生成语音字幕。它会下载选定的 Whisper 模型,在设备上进行转录,并在时间线上创建可编辑的字幕片段。
字幕面板
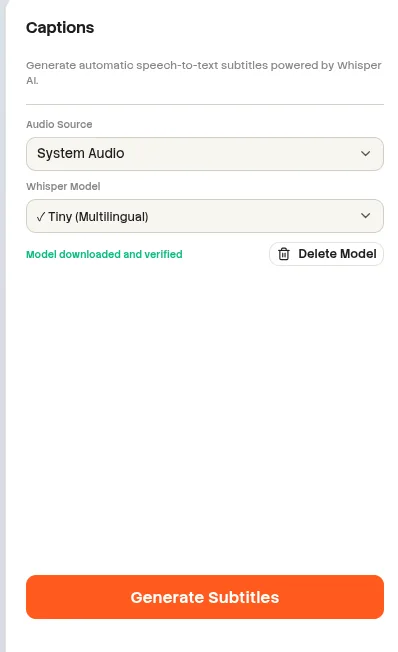
Screenshot pendingAdd the image at:
website/docs/public/screenshots/editor/captions-panel.webp音频来源
| 来源 | 出现条件 | 选择规则 |
|---|---|---|
| 系统音频 | 存在一个启用且角色为 System 的片段。 | 标识为 System Audio。 |
| 麦克风 | 存在一个启用且角色为 Microphone 的片段。 | 标识为 Microphone。 |
| 导入的音频 | 存在一个启用的导入音频片段。 | 使用片段名称。 |
| 重复的媒体 URL | 两个启用的片段引用相同的音频 URL。 | 只提供第一个来源。 |
| 没有可用来源 | 没有启用的音频片段拥有可读取的资源 URL。 | 无法生成字幕。 |
Whisper 模型
| 模型 | 语言 | 性能说明 |
|---|---|---|
| Tiny | 多语言 | 默认模型。 |
| Tiny .en | 英语 | 仅支持英语的模型。 |
| Base | 多语言 | 没有额外警告。 |
| Base .en | 英语 | 仅支持英语的模型。 |
| Small | 多语言 | 没有 WebGPU 时可能较慢。 |
| Small .en | 英语 | 没有 WebGPU 时可能较慢。 |
| Medium | 多语言 | 下载量较大;建议使用 WebGPU。 |
| Medium .en | 英语 | 下载量较大;建议使用 WebGPU。 |
| Large v3 | 多语言 | 没有 WebGPU 时下载量非常大且速度较慢。 |
模型下载和删除
| 状态或操作 | 行为 |
|---|---|
| 缺失 | 可以为选定的模型下载模型。 |
| 下载中 | Beam 会通过进度条报告已下载字节数和总字节数。 |
| 就绪 | 勾选标记会标识已安装的模型,并且“删除模型”变为可用。 |
| 删除模型 | 在下载、删除或转录期间不可用。 |
| 下载错误 | 错误会显示出来,并且可以复制用于诊断。 |
生成和重新生成
- 选择一个已启用的音频来源。
- 如果 Whisper 模型尚未就绪,请选择并下载一个模型。
- 选择“生成字幕”。Beam 会解码来源,将其转换为单声道 16 kHz 音频,并将其限制在时间线时长内。
- 处理继续进行时,部分转录结果会更新编排。
- 运行完成后,会选择第一条生成的字幕以便编辑。
| 行为 | 规则 |
|---|---|
| 句子分组 | 在标点处或达到 12 个词后结束字幕短语。 |
| 生成片段的最短时长 | 40 ms。 |
| 重新生成 | 替换已有的 AI 生成字幕,同时保留手动字幕。 |
| 取消 | 停止模型加载或转录。 |
| 关闭面板 | 取消当前正在进行的转录。 |
| 诊断 | 报告耗时,并在处理后提供可复制的转录报告。 |
本地转录
Whisper 在设备上运行。生成字幕不需要上传到云端或使用 API 密钥。
编辑生成的字幕
生成的字幕是标记为 AI 生成的普通可编辑字幕片段。生成后,可以通过片段面板和时间线调整其文本、时序和视觉样式。