

Napisy AI
Beam generuje podpisy mowy lokalnie z włączonego klipu audio. Pobiera wybrany model Whisper, dokonuje transkrypcji na urządzeniu i tworzy edytowalne klipy z napisami na osi czasu.
Panel napisów
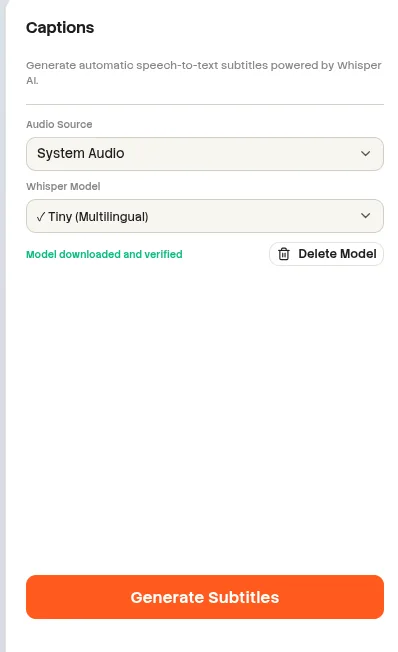
Screenshot pendingAdd the image at:
website/docs/public/screenshots/editor/captions-panel.webpŹródła dźwięku
| Źródło | Kiedy się pojawi | Reguła wyboru |
|---|---|---|
| Dźwięk systemowy | Istnieje włączony klip z rolą System. | Identyfikowany jako dźwięk systemowy. |
| Mikrofon | Istnieje włączony klip z rolą Mikrofon. | Identyfikowany jako Mikrofon. |
| Importowany dźwięk | Istnieje włączony zaimportowany klip audio. | Używa nazwy klipu. |
| Zduplikowany adres URL multimediów | Dwa włączone klipy odwołują się do tego samego adresu URL dźwięku. | Oferowane jest tylko pierwsze źródło. |
| Brak użytecznego źródła | Żaden włączony klip audio nie ma czytelnego adresu URL zasobu. | Generowanie pozostaje niedostępne. |
Modele szeptów
| Modelka | Języki | Wskazówki dotyczące wydajności |
|---|---|---|
| Tiny | Wielojęzyczny | Domyślny model. |
| Tiny.en | Angielski | Model wyłącznie w języku angielskim. |
| Base | Wielojęzyczny | Brak dodatkowego ostrzeżenia. |
| Base.en | Angielski | Model wyłącznie w języku angielskim. |
| Small | Wielojęzyczny | Może działać wolno bez WebGPU. |
| Small.en | Angielski | Może działać wolno bez WebGPU. |
| Medium | Wielojęzyczny | Duży plik do pobrania; Zalecane WebGPU. |
| Medium.en | Angielski | Duży plik do pobrania; Zalecane WebGPU. |
| Large v3 | Wielojęzyczny | Bardzo duży i wolny bez WebGPU. |
Pobieranie i usuwanie modelu
| Stan lub działanie | Zachowanie |
|---|---|
| Brak | Opcja Pobierz model jest dostępna dla wybranego modelu. |
| Pobieranie | Beam raportuje pobrane dane i całkowitą liczbę bajtów z paskiem postępu. |
| Gotowy | Znacznik wyboru wskazuje zainstalowany model i dostępna jest opcja Usuń model. |
| Usuń model | Niedostępne podczas pobierania, usuwania lub transkrypcji. |
| Błąd pobierania | Błąd zostanie wyświetlony i można go skopiować do celów diagnostycznych. |
Generuj i regeneruj
- Wybierz jedno z włączonych źródeł dźwięku.
- Wybierz i pobierz model Whisper, jeśli nie jest jeszcze gotowy.
- Wybierz opcję Generuj podpisy. Beam dekoduje źródło, konwertuje je na dźwięk mono 16 kHz i ogranicza do czasu trwania.
- Wyniki częściowej transkrypcji aktualizują kompozycję podczas kontynuowania przetwarzania.
- Po zakończeniu przebiegu wybierany jest do edycji pierwszy wygenerowany podpis.
| Zachowanie | Reguła |
|---|---|
| Grupowanie zdań | Kończy frazę podpisu w miejscu znaków interpunkcyjnych lub po 12 słowach. |
| Minimalny czas trwania wygenerowanego klipu | 40 ms. |
| Zregeneruj się | Zastępuje istniejące napisy generowane przez sztuczną inteligencję i zachowuje napisy ręczne. |
| Anuluj | Zatrzymuje ładowanie modelu lub transkrypcję. |
| Zamknij panel | Anuluje aktywny przebieg transkrypcji. |
| Diagnostyka | Raportuje upływ czasu i po przetworzeniu udostępnia raport transkrypcji, który można skopiować. |
Transkrypcja lokalna
Szept działa na urządzeniu. Generowanie napisów nie wymaga przesyłania do chmury ani klucza API.
Edytuj wygenerowane podpisy
Wygenerowane napisy to zwykłe edytowalne klipy z napisami, oznaczone jako wygenerowane przez sztuczną inteligencję. Ich tekst, czas i styl wizualny można dostosować po wygenerowaniu za pomocą panelu Klip i osi czasu.