

AI 자막
Beam은 활성화된 오디오 클립에서 음성을 로컬로 자막으로 생성합니다. 선택한 Whisper 모델을 다운로드하고 장치에서 전사한 다음 타임라인에 편집 가능한 자막 클립을 만듭니다.
자막 패널
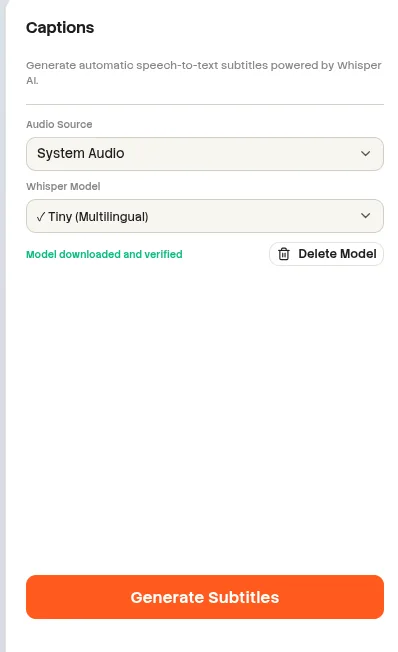
Screenshot pendingAdd the image at:
website/docs/public/screenshots/editor/captions-panel.webp오디오 소스
| 소스 | 표시되는 조건 | 선택 규칙 |
|---|---|---|
| 시스템 오디오 | System 역할의 활성화된 클립이 있습니다. | System Audio로 식별됩니다. |
| 마이크 | Microphone 역할의 활성화된 클립이 있습니다. | Microphone으로 식별됩니다. |
| 가져온 오디오 | 활성화된 가져온 오디오 클립이 있습니다. | 클립 이름을 사용합니다. |
| 중복 미디어 URL | 두 개의 활성화된 클립이 같은 오디오 URL을 참조합니다. | 첫 번째 소스만 제공됩니다. |
| 사용 가능한 소스 없음 | 읽을 수 있는 자산 URL이 있는 활성화된 오디오 클립이 없습니다. | 생성 기능을 사용할 수 없습니다. |
Whisper 모델
| 모델 | 언어 | 성능 안내 |
|---|---|---|
| Tiny | 다국어 | 기본 모델입니다. |
| Tiny.en | 영어 | 영어 전용 모델입니다. |
| Base | 다국어 | 추가 경고가 없습니다. |
| Base.en | 영어 | 영어 전용 모델입니다. |
| Small | 다국어 | WebGPU가 없으면 느릴 수 있습니다. |
| Small.en | 영어 | WebGPU가 없으면 느릴 수 있습니다. |
| Medium | 다국어 | 다운로드 용량이 큽니다. WebGPU를 권장합니다. |
| Medium.en | 영어 | 다운로드 용량이 큽니다. WebGPU를 권장합니다. |
| Large v3 | 다국어 | WebGPU가 없으면 매우 크고 느립니다. |
모델 다운로드 및 삭제
| 상태 또는 작업 | 동작 |
|---|---|
| 없음 | 선택한 모델에 대해 모델 다운로드를 사용할 수 있습니다. |
| 다운로드 중 | Beam은 진행률 표시줄과 함께 다운로드된 바이트 및 전체 바이트를 보고합니다. |
| 준비됨 | 확인 표시로 설치된 모델을 식별하고 모델 삭제를 사용할 수 있게 됩니다. |
| 모델 삭제 | 다운로드, 삭제 또는 전사 중에는 사용할 수 없습니다. |
| 다운로드 오류 | 오류가 표시되며 진단을 위해 복사할 수 있습니다. |
생성 및 재생성
- 활성화된 오디오 소스 중 하나를 선택하세요.
- 준비되지 않았다면 Whisper 모델을 선택하고 다운로드하세요.
- 자막 생성을 선택하세요. Beam은 소스를 디코딩하고 모노 16kHz 오디오로 변환한 다음 타임라인 길이로 제한합니다.
- 처리가 계속되는 동안 부분 전사 결과가 구성을 업데이트합니다.
- 실행이 완료되면 처음 생성된 자막이 편집을 위해 선택됩니다.
| 동작 | 규칙 |
|---|---|
| 문장 그룹화 | 구두점에서 또는 12단어 뒤에 자막 문구를 끝냅니다. |
| 생성되는 클립의 최소 길이 | 40ms. |
| 재생성 | 기존 AI 생성 자막을 교체하고 수동 자막은 보존합니다. |
| 취소 | 모델 로딩 또는 전사를 중지합니다. |
| 패널 닫기 | 활성 전사 실행을 취소합니다. |
| 진단 | 처리 후 경과 시간을 보고하고 복사할 수 있는 전사 보고서를 제공합니다. |
로컬 전사
Whisper는 장치에서 실행됩니다. 자막 생성에는 클라우드 업로드나 API 키가 필요하지 않습니다.
생성된 자막 편집
생성된 자막은 AI 생성으로 표시된 일반 편집 가능 자막 클립입니다. 생성 후 클립 패널과 타임라인에서 텍스트, 타이밍 및 시각적 스타일을 조정할 수 있습니다.