

AI 字幕
Beam 會從啟用的音訊片段在本地生成語音字幕。它會下載選定的 Whisper 模型,在裝置上進行轉錄,並在時間線上建立可編輯的字幕片段。
字幕面板
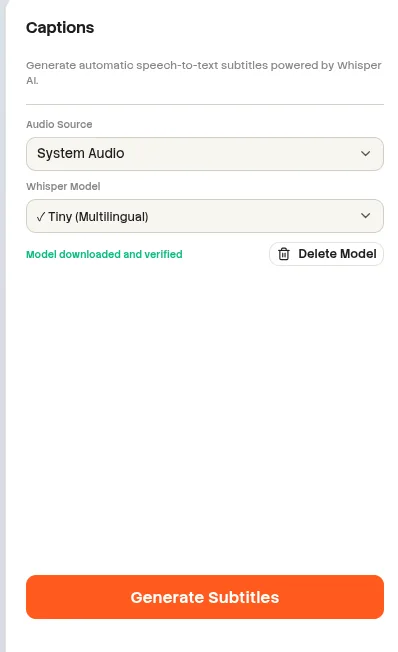
Screenshot pendingAdd the image at:
website/docs/public/screenshots/editor/captions-panel.webp音訊來源
| 來源 | 出現條件 | 選擇規則 |
|---|---|---|
| 系統音訊 | 存在一個啟用且角色為 System 的片段。 | 標識為 System Audio。 |
| 麥克風 | 存在一個啟用且角色為 Microphone 的片段。 | 標識為 Microphone。 |
| 匯入的音訊 | 存在一個啟用的匯入音訊片段。 | 使用片段名稱。 |
| 重複的媒體 URL | 兩個啟用的片段引用相同的音訊 URL。 | 只提供第一個來源。 |
| 沒有可用來源 | 沒有啟用的音訊片段擁有可讀取的資源 URL。 | 無法生成字幕。 |
Whisper 模型
| 模型 | 語言 | 效能說明 |
|---|---|---|
| Tiny | 多語言 | 預設模型。 |
| Tiny .en | 英語 | 僅支援英語的模型。 |
| Base | 多語言 | 沒有額外警告。 |
| Base .en | 英語 | 僅支援英語的模型。 |
| Small | 多語言 | 沒有 WebGPU 時可能較慢。 |
| Small .en | 英語 | 沒有 WebGPU 時可能較慢。 |
| Medium | 多語言 | 下載量較大;建議使用 WebGPU。 |
| Medium .en | 英語 | 下載量較大;建議使用 WebGPU。 |
| Large v3 | 多語言 | 沒有 WebGPU 時下載量非常大且速度較慢。 |
模型下載和刪除
| 狀態或操作 | 行為 |
|---|---|
| 缺失 | 可以為選定的模型下載模型。 |
| 下載中 | Beam 會透過進度條報告已下載位元組數和總位元組數。 |
| 就緒 | 勾選標記會標識已安裝的模型,並且“刪除模型”變為可用。 |
| 刪除模型 | 在下載、刪除或轉錄期間不可用。 |
| 下載錯誤 | 錯誤會顯示出來,並且可以複製用於診斷。 |
生成和重新生成
- 選擇一個已啟用的音訊來源。
- 如果 Whisper 模型尚未就緒,請選擇並下載一個模型。
- 選擇“生成字幕”。Beam 會解碼來源,將其轉換為單聲道 16 kHz 音訊,並將其限制在時間線時長內。
- 處理繼續進行時,部分轉錄結果會更新編排。
- 執行完成後,會選擇第一條生成的字幕以便編輯。
| 行為 | 規則 |
|---|---|
| 句子分組 | 在標點處或達到 12 個詞後結束字幕短語。 |
| 生成片段的最短時長 | 40 ms。 |
| 重新生成 | 替換已有的 AI 生成字幕,同時保留手動字幕。 |
| 取消 | 停止模型載入或轉錄。 |
| 關閉面板 | 取消當前正在進行的轉錄。 |
| 診斷 | 報告耗時,並在處理後提供可複製的轉錄報告。 |
本地轉錄
Whisper 在裝置上執行。生成字幕不需要上傳到雲端或使用 API 金鑰。
編輯生成的字幕
生成的字幕是標記為 AI 生成的普通可編輯字幕片段。生成後,可以透過片段面板和時間線調整其文字、時序和視覺樣式。